关于 OPD 梯度的一个简单分析
本页目录↓
一条推理回答可能有上千个 token,真正主导学习的却只有很少的位置。Beyond the 80/20 Rule 用最高熵的20%位置进行RLVR更新,在Qwen3-8B上保持了接近全量更新的效果,在更大模型上还取得了提升。1% of Tokens Can Be Enough 则把OPD的监督预算压到了0.1%–1%,在多个数学和医学推理设置中仍然接近或超过全量OPD。少量token足够,已经是值得解释的实测现象。
另一个相关现象出现在 on-policy distillation(OPD)里:压低学生自己生成、但教师不支持的 token,可能带来明显收益。不过,压低一个 token 后,其他候选会怎样变化?它们会更符合教师偏好,还是进一步强化学生原本的偏好?
我们围绕这两个问题做了一轮诊断和实验。本文的核心判断是:有效更新在softmax几何下已经高度集中,熵筛选抓住了同一批大梯度位置;而负信号挤压一个token时,背景候选的竞争会继续放大学生原有的偏好。 一个决定学习信号集中在哪里,另一个决定被压下来的候选如何影响其余候选。
1. 为什么少量 token 更新就足够
1.1 有效更新预算集中在少数 token
固定一个 prefix,学生分布记为 ,实际生成的 token 为 。用 detached 的标量信号 训练这个 token:
在 OPD 中,这个信号常取教师与学生对同一 token 的 log-probability 差。记 score gradient 为 ,那么这一个 token 对原始梯度下降方向的贡献就是 。
softmax 有一个重要的分解:
这里的 是该 token 相对其余候选的 log-odds 梯度。因此,单个 token 在裁剪和优化器之前的贡献长度为
它取决于学习信号、学生置信度和参数空间中的剩余梯度尺度。即使两个 token 得到相同的信号,其贡献也可能差很多。
例如, 与 都可以被口头描述为“很自信”,但两者的 分别为 和 ,相差约十五万倍。若其他因素相近,它们给训练带来的原始更新预算也会差约十五万倍。
这套几何贯穿SFT和OPD:token交叉熵使用相同的score gradient,监督方式决定前面的信号,softmax则决定信号进入模型时的尺度。
1.2 我们的数据里,集中程度有多强?
最初的诊断包含 8 条短算术 rollout,每条测量 32 个输出 token,共 256 个位置。对每个位置,我们计算了全参数 score norm,并用稳定的 得到 ,避免接近 1 的概率在相减时丢失精度。
| 量 | 这批数据中的结果 |
|---|---|
| score norm 的范围 | 到 |
| 剩余范数 的 5% / 50% / 95% 分位数 | 491 / 1264 / 3138 |
| 对 回归的斜率 | 1.029 |
| 上述回归的 | 0.9971 |
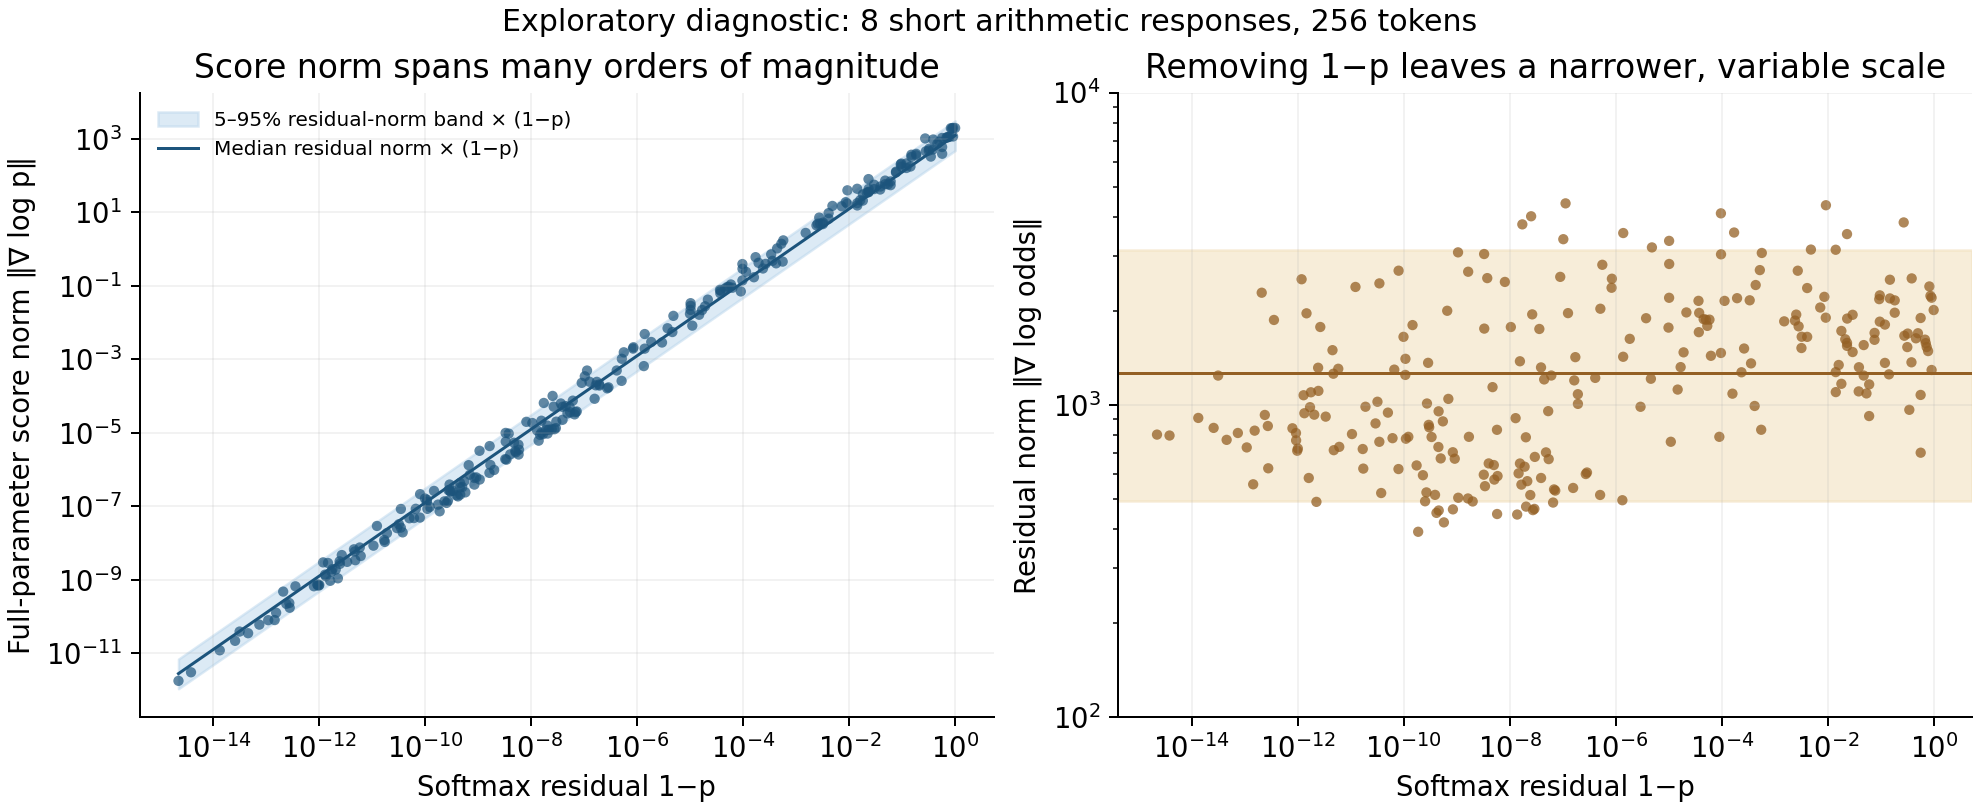
图中左侧的score norm跨约15个数量级;右侧去掉 后,剩余范数的90%区间缩到了约6.4倍。在这批数据里,决定梯度数量级的主要因素就是 。
在这批样本中, 的位置只有 28/256,即 10.94%,却占据了:
- 92.52% 的逐 token score norm 总和;这也对应统一负信号下的贡献长度分布。
- 97.14% 的实际 teacher-gap 加权贡献长度总和 。
全token训练已经在实际执行一种极不均匀的预算分配:约11%的位置拿走97%的teacher-gap加权贡献,其余位置共享剩下约3%。从这个角度看,稀疏更新是在把已有的集中结构显式化。
1.3 高熵筛选抓住了同一批大梯度 token
我们把学生熵、sampled-token probability和全参数score norm分别排序,然后比较它们选出的最高熵、最低概率和最大范数位置。最高20%口径下,三个集合各有52个位置。
| 比较项 | 实测结果 |
|---|---|
| 最高熵与最低概率集合重合 | 52/52,100% |
| 最高熵与最大score norm集合重合 | 51/52,98.08% |
| 最高熵集合保留的score-norm预算 | 99.27% |
| 最高熵集合保留的teacher-gap加权预算 | 99.21% |
在这些rollout上,高熵选择器就是一个几乎精确的大梯度选择器。 高熵、低概率、大梯度,描述的是同一批主导更新的位置。选出约20%的token,就保留了99%以上的预算:筛选抓住的是实际承担学习的核心位置。
这给高熵token的作用提供了直接的优化解释:低置信度使 保持较大的尺度,学习信号得以进入模型;高置信度使这个因子趋近于零,许多位置在训练中已经近乎静默。熵筛选抓住了这种差别,把更新集中到了模型真正会响应的位置。
因此,我们主张把“高熵token重要”与“梯度预算集中”放在一起理解。80/20论文用推理分叉描述高熵位置;我们的诊断从优化侧给出解释:这些位置的梯度尺度让它们承担了绝大部分更新份额。Token-Level Analysis of Sampled-Token Reverse-KL OPD 在logit梯度中同样分解出了teacher gap和 这两个因子。
1.4 从20%到0.1%:有效更新可以极度稀疏
80/20论文已经把稀疏更新做成了训练实验:只对最高熵20%的位置施加policy gradient,Qwen3-8B的效果接近全量更新;在Qwen3-32B上,AIME’25提升11.04个百分点。这为“少量token足够”提供了直接的任务效果证据。原文实验
我们的数据解释了这个结果为何合理:20%的位置已经承载了99%以上的逐token更新预算。 全token训练中的大量位置具有极小的 ,计算了loss、参与了反传,却只分到很少的预算。集中监督主导位置,已经保留了绝大部分有分量的学习信号。
0.1%预算的结果把这个思路进一步推进到了信号质量。1% of Tokens Can Be Enough 使用信息效率比IER衡量sampled gradient的信号与估计噪声,并与已有的token选择分数结合。在名义0.1%预算下,IER在医学任务上的HealthBench整体分数达到45.25,全量OPD为45.77;数学任务中也出现了接近或超过全量更新的结果。
从20%到0.1%,筛选逐渐从“抓住大部分预算”走向“把预算花在可靠的信号上”。前者利用更新幅度的集中,后者进一步利用监督质量与梯度估计质量的差异。学习的有效密度远高于token的数量密度:保留有用且可靠的更新,可以用很少的位置完成原本铺在整条回答上的学习。
2. 挤压效应:压低一个 token,谁的偏好会被强化?
2.1 负信号的接收方向包含学生自己的分布
同样固定 prefix。普通 token loss 的 logit 梯度下降方向为
当 时,令 。假设直接对 logits 做一步 SGD,会得到
source token 的 logit 被压低,其余候选的 logits 被抬高,而且学生原本概率更高的候选获得更大的抬升。这是我这里所说的“挤压效应”的局部结构。
它不只是更新量不同。对两个未被采样的候选 ,有
若学生原本更偏好 ,这一次负信号更新就会继续扩大 相对 的优势。教师对 sampled token 的标量否定,并没有在这一项里逐一指定其余候选的接收量。
2.2 一个具体例子:logit 上升,概率却下降
设学生和教师分别为
三个候选依次记为 。学生更偏好 ,教师更偏好 。如果这次采到了 ,教师给出的 gap 为 。
取有效步长 ,普通负信号更新的 logit 变化是 。重新做 softmax 后:
| 候选 | 学生初始概率 | 普通负信号更新后 | 教师概率 |
|---|---|---|---|
| :学生偏好的候选 | 0.70000 | 0.73407 | 0.20 |
| :教师更支持的候选 | 0.20000 | 0.18978 | 0.75 |
| :这次被否定的 token | 0.10000 | 0.07615 | 0.05 |
被成功压低了,但教师更支持的 也下降了。尽管 的 logit 上升, 上升得更多,softmax 归一化让 的概率下降。
这说明,判断接收方向时不能只看哪些 logits 得到了正更新。logit 更新、概率变化和真实网络的参数更新,是不同的量。
2.3 这也是教师路由的直觉来源
如果保持 sampled source 的抑制量,改把接收方向指向教师相对学生的概率缺口,即
那么上面的例子里,接收候选就是 。用同样的 source logit 下降量,可以构造 ,更新后的分布为 。
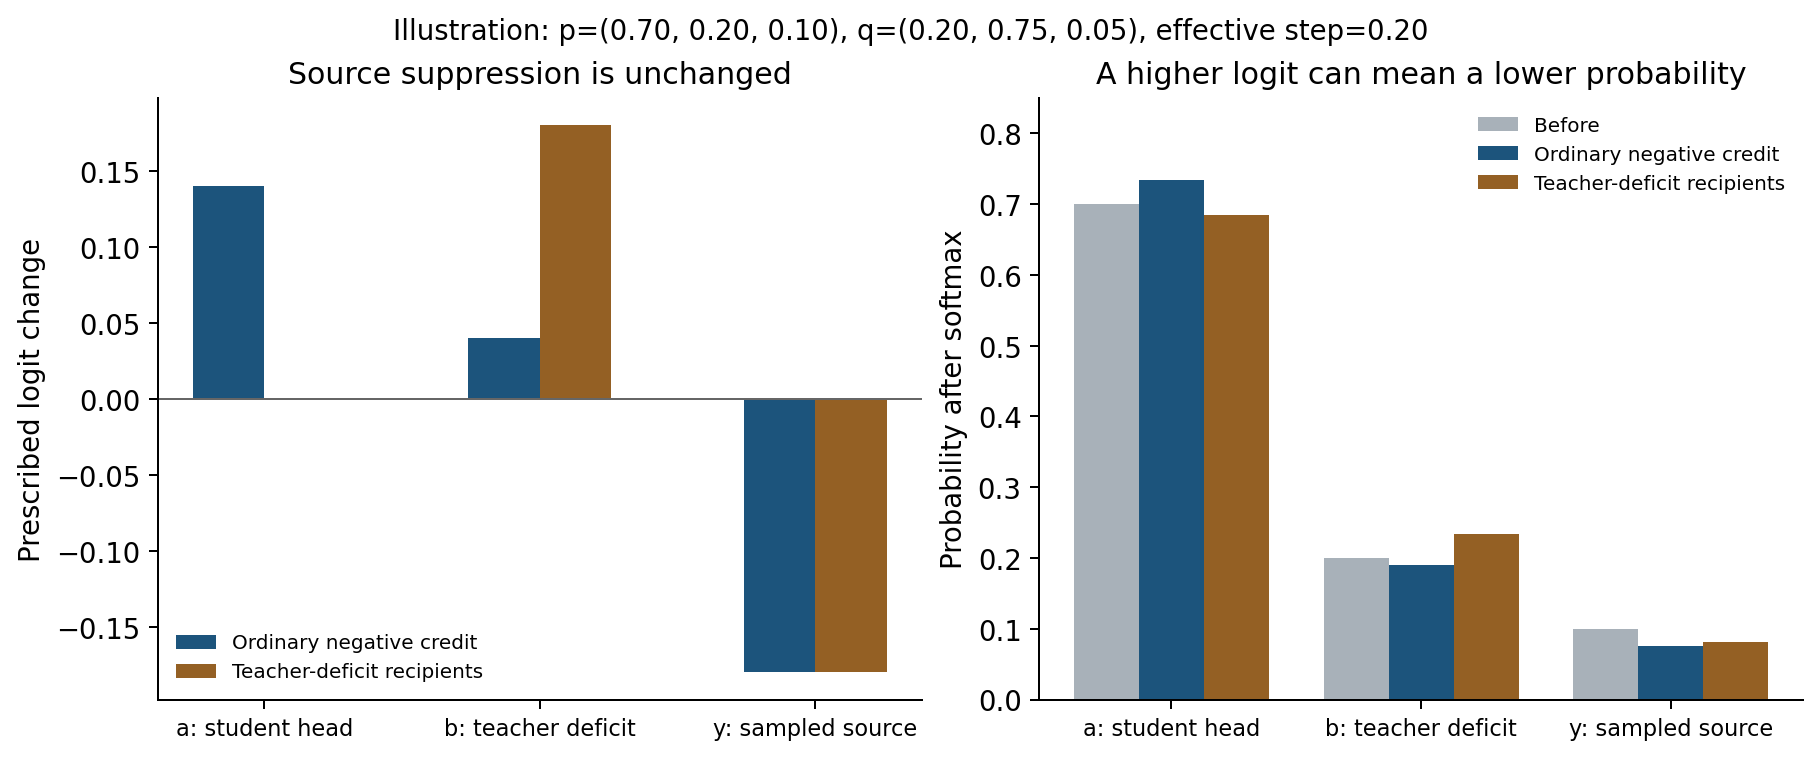
这里确实提升了教师更支持的 。但两个更新中 的最终概率并不相同,虽然它的 logit 下降量相同。我们控制的是 logit 信号,不能把它描述为已经精确搬运了相同的概率质量。
图和表是直接更新三个 logits 的手算示例,不是语言模型的实测参数更新。真实网络还要乘模型 Jacobian,经多个位置聚合后进入优化器。RouteOPD 将教师偏好的 source–destination 关系显式纳入 pairwise 目标;我们后来测试的是另一个负信号反传原型,并非该论文的复现。
2.4 OPD怎样把教师偏好叠加到挤压效应上
OPD里同时存在两层机制:每次负信号更新中的softmax竞争,以及跨采样的教师监督。前者按学生分布分配接收量,后者通过每个候选的teacher gap调节正负信号。
仍在固定 prefix、纯 on-policy、未裁剪的条件下,令每个候选的信号为 。对所有可能采样求期望:
上面的示例考察了采到 的一次负信号;如果采到教师更支持的 ,它会得到正信号。把各次采样平均以后,普通OPD的局部期望会提升 。教师偏好通过不同候选的gap进入期望更新,学生偏好则体现在每次sampled update的竞争结构里。
这也让显式路由的作用更清楚:它把教师偏好直接放进某次负信号的接收方向,在有限采样中主动选择接收候选。普通OPD已经拥有教师监督,路由改变的是这份监督在单次更新中的使用方式。
OPSA 则从另一侧提供了证据:其教师无关更新在多个设置中取得收益,说明调整学生已有分布、抑制尾部模式,本身就有学习价值。教师监督和学生分布重整可以同时发挥作用,分别影响新偏好的引入和已有偏好的竞争。
2.5 教师路由:一个值得继续研究的着陆点
把接收偏好交给教师,是挤压效应一个自然的算法着陆点。 既然少数位置承担了绝大部分更新,就值得进一步设计这些位置的接收方向,让教师对候选之间的相对偏好直接进入更新。
RouteOPD 已经给出了正向实验结果:在四组教师—学生设置中,相对sampled-RKL OPD,四项数学benchmark的平均准确率提升2.19–3.61个百分点,跨设置平均提升2.70个百分点。它将学生概率盈余与教师概率缺口组成source–destination pairs,再使用共享的有界教师potential构造pairwise log-odds目标,配合Huber loss和自适应预算。教师偏好的接收方向、目标形式和更新强度,在这个设计中共同发挥作用。
我们也在 EOPD 上做了一个更直接的反传原型:保留sampled teacher gap、PPO clipping与正信号分支,仅在负信号分支中把接收方向替换成teacher top16内的 。该原型保持source抑制和停止token的直接score梯度,测试的是“保持原信用信号、改变接收方向”这一实现切面。它与RouteOPD的pairwise目标和自适应预算,是两种不同的算法实现。
这次原型的MATH500 Avg@8为67.90%,EOPD基线为68.275%;Pass@8分别为86.40%和87.60%。完整设置和逐题结果保存在实验记录。这组初步结果为后续比较接收规则、路由预算和作用位置留下了一个可复用的起点;RouteOPD的正向结果则说明,值得继续打磨的是如何把教师偏好落实为有效更新。
这里有三个很具体的后续问题:
- 位置选择与接收方向一起设计。 用高熵、大梯度或IER筛出有用且可靠的位置,再在这些位置上引入教师接收偏好,让稀疏监督同时解决“在哪里学”和“向哪里学”。
- 让路由强度适应教师需求。 教师缺口的大小、集中程度和不确定性可以共同决定预算,把更新量与实际需要纠正的分布差异匹配起来。
- 比较目标形式。 直接改backward、拟合pairwise log-odds、加入条件化FKL,分别通过不同的学习几何实现教师偏好。这些形式与PPO约束、优化器的配合值得系统比较。
稀疏更新回答“在哪些位置学”,教师路由回答“向哪些候选学”。 两个视角结合起来,就是把有限的学习预算集中到关键位置,再用教师偏好塑造这些位置上的竞争。这是本文两个观察可以共同落到算法设计上的地方。
我们留下的两个判断很清楚:少量token之所以能承担训练,是因为有效更新预算本来就高度集中;负信号压低一个token时,softmax竞争会放大学生背景候选的既有排序。 教师监督再通过不同候选的学习信号,或显式的接收方向,影响这种竞争。前一个视角解释更新为什么稀疏,后一个视角解释更新怎样塑造偏好。
数据与复核材料:原始逐 token 数据、熵与概率重合分析、完整对照结果。两张图的数值和生成脚本均已保存,可用绘图脚本重新生成;材料打包下载包含所需数据和目录结构。
数据说明:文中的256位置来自8条短算术rollout;早期loader使用BF16参数,embedding与输出头的共享关系在后续正式训练中恢复。范数预算采用逐token贡献长度累加的口径,最高20%按分位数选择得到52个位置。熵描述完整分布,sampled probability描述实际采到的token;本文报告的是这批数据中三种选择器的实测重合。路由实验采用自定义backward,原sampled loss值保留作诊断,任务效果采用单seed独立评测。