从一个 toy model 出发的 Transformer 机制解释性
Transformer 最开始并不会“理解上下文”。它先学会一个 bigram 统计表,然后学会把远处 token 携带的信息搬到当前位置,最后才学会:当前预测需要什么信息,以及应该向前文中的谁索取。
我们已经听过太多关于 Q、K、V 的比喻:Query 是问题,Key 是索引,Value 是内容;Attention 像搜索,像数据库,像图书馆。
这些比喻不能说错,但它们跳过了真正有意思的问题:
为什么梯度下降会把 Q、K、V 训练成这样的东西?
如果没有回答这个问题,“Q 是查询、K 是键”就只是对公式运行方式的复述,而不是机制解释。
ICLR 2026 论文 How Do Transformers Learn to Associate Tokens: Gradient Leading Terms Bring Mechanistic Interpretability 给出了一个少见的、相当漂亮的答案。作者从一个三层 attention-only toy model 出发,对训练初期的梯度做 leading-term 展开,得到各组参数的近似闭式解。结果不是一堆无法阅读的高阶张量,而是三种朴素的语料统计量:
- bigram:一个 token 后面通常接什么;
- interchangeability:哪些 token 能放进相似的功能槽位;
- context:一个 token 出现之前,较长前缀里通常有什么。
更漂亮的是,这三种统计量不是平行地塞进模型。它们按照梯度能够传播的顺序,依次长成 output、value 和 query-key attention:
这给出了一个比“查字典”更准确的 attention 图景:
Value 定义一个历史 token 能供应什么预测修正;Query-Key 定义当前 token 对这种修正有多少需求。Attention 是供需匹配,Value 是匹配之后真正交付的东西。
下面我们从公式推导这个故事,再用自己训练的 TinyStories 三层模型检查它到底是不是真的。
1. 先把模型缩小到可以看穿
论文研究的不是完整 GPT,而是一个保留了 causal mask、residual stream 和相对位置编码的 attention-only Transformer。输入 token 直接表示成词表空间中的 one-hot 向量:
第 层写成:
最后输出 logits:
这里有一个必须提前说清的细节:论文直接分析的是合并后的 query-key 矩阵 。在标准 Transformer 里,它对应某种 的组合。单独的 和 存在基变换自由度,真正决定 attention score、因而更容易被识别的是它们的乘积。
所以本文说“QK 学到了什么”,而不会假装仅凭 score 就能唯一解释某一列 或 。
这个模型没有 MLP、LayerNorm 和成熟 LLM 的高维 embedding,当然不能解释 Transformer 的全部能力。但它保留了我们关心的因果链:
正因为模型足够小,这条链第一次能被梯度展开直接照亮。
2. 零初始化像一台训练动力学的 X 光机
设所有参数从零开始,使用交叉熵和学习率 做梯度下降。
初始化时发生两件事:
- ,所以所有 next-token logits 都是 0,预测是均匀分布;
- ,所以 causal attention 在所有可见前缀位置上均匀平均。
关键不是“零初始化适不适合训练现代 LLM”,而是它暂时切断了参数之间的耦合,让我们可以观察每条梯度路径第一次何时导通。
为了不让后面的闭式解像凭空出现,我们先保留一张最小的梯度地图。以下只写一层;零初始化下,各层拥有相同的 leading term。
记 为 next-token one-hot 标签,,并定义“模型还欠标签多少”的残差:
忽略公共常数与求和符号,链式法则的结构是:
是 attention softmax 的逐行 Jacobian。这三行已经预告了顺序: 不依赖 ; 必须经过 ;QK 则必须同时经过 与 。
2.1 第一步:只有 output matrix 能动
初始时 ,因此 ;又因为 ,logits 全为零, 是词表上的均匀分布 。代入第一条梯度链:
定义中心化 bigram 矩阵 :
这里没有隐藏的一步: 正是序列中 的转移次数。对数据与位置平均,第一项变成 bigram 的联合频率; 则是当前 token 频率乘均匀概率。两者相减恰好就是 。
于是第一次更新后:
这句话的含义非常朴素:如果当前 token 是 ,那么 给出的就是它的平均 next-token 分布相对均匀基线的偏移。
模型最先得到的能力不是上下文理解,而是一张统计续词表:
in   → the
was  → a
one  → day
.    → he / the
为什么此时 和 QK 都不动?因为 时,attention block 即便产生了信息,最终也没有 decoder 能把它读成 logits。下游读出器还是零,给上游的信息搬运系统就没有学习信号。
2.2 第二步:Value 学会“历史信息能怎样修改预测”
第一步以后, 已经会把 hidden state 解码成 bigram logits。现在改变历史 token 送来的 message,才可能改变 loss,于是 value gradient 第一次导通。
此时 QK 仍为零,所以 causal attention 仍是固定的均匀矩阵 :第 行的前 个位置均为 ,未来位置为 0。又有
把它们代入 的梯度,保留最低阶:
方括号为什么是 context mapping? 把位置 以前的 token 各取 , 再按 token 身份汇总。因此它的 元素就是:目标为 时,前缀中 的平均占比,减去均匀输出基线:
这正是 。于是第二次梯度下降更新为
若继续走 步, 在第 步前约为 。每一步写入 的 leading term 因而正比于 ,而
所以论文中的一般式并非直接猜出,而是每一步梯度累积的结果:
其中 的完整定义可写成:
衡量的是:当当前/目标 token 是 时, 多大程度上会出现在它之前的前缀中。
例如在 TinyStories 里:
fish  ← pond / water / whale / fisherman
birds ← tree / park / bird
此时 attention score 仍然接近均匀,但均匀平均已经足以让 学到第一种长程能力:一个较早出现的 token,应该向后续预测提供怎样的修正。
它是 ,也可以直接从计算图读出:
这比“V 保存内容”严格得多。更准确的说法是:
V 学到的是一个历史 token 对 next-token 分布所能提供的、可被输出层读取的统计修正。
2.3 第三步:QK 才终于有理由选择“听谁的”
只会搬运还不够。均匀 attention 会把所有历史 token 的 message 混在一起。只有当:
- 已经能制造有意义的 message;
- 已经能把 message 读成 logits;
改变 attention score 才会对 loss 产生一阶可见的影响。
因此 QK 的梯度路径至少包含:
阶数只能说明“何时出现”。把 与 代回 score gradient,去掉尺度常数后,核心依赖变成:
它衡量:为了修正某个 next-token 预测,每个前缀位置携带的信息有多有用。均匀点的 softmax Jacobian 随后删除未来位置,并减去可见前缀内的行均值。
这个中心化很有解释力:attention 只能学习“谁比当前平均历史更值得听”,给所有 key 同加一个常数不会改变 softmax。
把这个逐行 masked-and-centered 结果记为 。由于 第 行的标签是 ,它还完成了一次自然的 next-to-query 对齐:为预测 发现的证据,写入以当前 token 为 query 的 score。
最后用左右两侧的 one-hot ,把位置对汇总成词表中的 query-key token 对:
于是 的含义不是“ 和 经常共现”,而是:当当前 query token 是 时,关注历史 token ,是否能沿着“上下文 可替换候选 next-token”这条路径改善预测。
系数也有简单来源:第 次更新前, 已累积 份, 已累积 份,因此本次 QK 系数是 。对训练步求和后,leading term 为:
这个组合系数满足 时等于 2,恰好退化到上面的第三步结果。完整证明还要控制 softmax 线性化误差与各参数的高阶余项;它们决定近似在多长的早期窗口内成立,但不会改变这条机制链。
位置编码 也在同一阶出现,只是把相同的预测相关性投影到相对位置,而不是 token 对。
这条训练顺序是整篇论文最漂亮的部分:
| 出现顺序 | 参数 | 学到的初始功能 | 学习率阶 |
|---|---|---|---|
| 1 | 当前 token 的平均续词统计 | ||
| 2 | 历史 token 能提供什么预测修正 | ||
| 3 | 当前预测应该向哪个历史 token 索取修正 |
模型不是先被人工指定了 Q/K/V 的角色,再去填参数;恰恰相反,这些角色是由计算图中的梯度依赖顺序逼出来的。
3. 三种语料统计,如何组合成“语义”
3.1 :同一张表的行与列讲着两个故事
的第 行是被语料频率 缩放的 next-token predictive profile:给定当前 token 是 ,哪些输出会比均匀基线更可能。
in   → the
fish → swam / swimming
.    → he / the
但接下来真正进入 Gram matrix 的是列。记第 列为
收集所有可能前驱对候选 token 的预测证据。若 与 相似,说明 被相似的前驱以相似方式预测,因此能进入相似的语言槽位。
例如 happy/sad/excited/scared 都常接在 she was ... 后面。它们未必同义,却具有相似的 predictive role。这里学到的是功能可替换性,不是人类词典中的语义类别。
3.2 :相似性只是故事的一半
论文把
解释为 interchangeability mapping,因为
但内积不等于纯 cosine。令
并令 ;零范数列的 cosine 记为 0。于是有一个完全精确的分解:
论文使用 interchangeability 来解释这个 Gram matrix; 是本文为了把“证据强度”和“角色相似度”拆开而做的等价重写,不是额外假设。
这里的 才是纯粹的 role similarity; 则表示两端各自拥有多少 predictive statistical strength。因此 更准确的名字是:
统计证据加权的功能相似度。
也不只是词频。由 的定义,
它同时考虑前驱有多常见、预测偏离均匀基线有多强,以及有多少前驱共同支持 。方向回答“扮演什么角色”,范数回答“这个角色有多少语料证据”。
这也解释了为什么不能只用 cosine。一个罕见 token 即便偶然与 fish 方向平行,只要 很小,它就没有资格完整继承 fish 的证据。
3.3 :一个 context token 的候选清单
越过直接相邻关系,总结长程前缀。给定历史 token ,定义
是一张 future-token association 清单:第 项表示 出现在前文时,未来 token 获得多少直接统计支持。
例如语料频繁出现 pond ... fish,那么 。这只是直接的长程关联,还没有把证据泛化给 frog 等功能相近的 token。
3.4 :统计支撑下的相似性传播
现在让 context evidence 经过 interchangeability kernel:
它的第 项可以完全展开为:
这串乘法可以从右向左读:
- :context 直接支持候选 ;
- :这份候选证据本身是否可靠;
- :把证据传播给 predictive role 相似的 ;
- :接收者 自己是否也有足够统计支撑。
假设 pond 直接支持 fish,但几乎不直接支持 frog:
若 、,且二者的 role cosine 是 ,那么 fish 向 frog 传播的间接贡献约为
于是模型能把语料中见过的 pond → fish,泛化为没有被同样频繁直接观察到的 pond → frog。cosine 决定“往哪里泛化”,两侧的 决定“有多少证据和资格泛化”。
若 ,这条路径也可以传递抑制而非支持。因此它不是概率扩散,而是带符号、带证据强度的 kernel propagation。
所谓“语义”在这里并不是额外注入的神秘对象,而是长程共现证据沿功能相似性进行的一次强度加权传播。
4. 为什么 Attention 的本质是供需匹配
4.1 :把输出愿望编码成 hidden message
Value 的 leading term 是
给定历史 token ,第一步
列出它希望提高或压低的 future tokens。可以把它看成一张“输出愿望清单”。但 value vector 活在 hidden space,不能直接把这张清单塞进 logits。
于是第二步乘 :
在这个 toy model 中,hidden basis 与 token basis 重合。它的第 个 hidden 坐标为
换句话说,它在寻找:哪些 hidden basis 经输出层解码后,恰好能产生这张候选清单。 在这里不是 inverse,而是输出层的 adjoint——一次 matched-filter 式的反投影。
因此, 可以读成:
先决定一个历史 token 想对输出说什么,再把这句话编码成输出层听得懂的 hidden message。
4.2 message 真正送达 logits 后发生什么?
raw value message 最终还要经过 :
这正是上一节的 evidence-weighted similarity propagation,只是采用了 forward pass 的行向量写法。
| 表达式 | 它在做什么 |
|---|---|
| context 给出的直接候选清单 | |
| 把候选清单编码为 hidden message | |
| message 被解码后,对 logits 的实际影响 |
因此“V 保存 token 内容”是一个过于静态的说法。这里的 V 更像一个编译器:把长程 context evidence 编译成当前输出系统可以执行的预测修正。
把 leading terms 放回一层模型,忽略尺度常数:
4.3 QK:当前预测是否需要这份供给?
每个历史 token 都能生产一份 message,但并非每个位置都应该接收。QK 要学习的,就是 message 与当前预测缺口之间的兼容性。
当前 query 对历史 token 的 score 为
的形成可以解释成三步:
- 用真实 next-token residual 判断 的 logit message 是否能减少当前错误;
- 用 causal mask 排除未来,并与当前前缀中的平均 usefulness 比较;
- 把结果写入“当前 query token—历史 key token”这对词表坐标。
于是 QK 学到的不是一般意义上的 token 相似度,而是:
当 query 正准备预测下一个 token 时,历史 token 所供应的修正,是否恰好是它现在需要的?
这就是 attention 的供需含义:
- Query 表达当前预测缺什么;
- Key 标识一个历史位置能提供哪类证据;
- QK score 衡量需求与供给是否匹配;
- Value 把匹配成功后的证据编码成 hidden message;
- 将 message 解码,并沿统计可靠的功能相似性完成泛化。
“Q 和 K 做检索”只描述了操作。“供需匹配”则解释了为什么 next-token loss 会让它检索这些东西。
5. 我们如何复现这个故事
我们基于作者的开源实现,复现了论文的 TinyStories 第一阶段,并针对共享 A800 做了等价的低显存改写。
实验配置:
| 配置 | 数值 |
|---|---|
| 模型 | 3 层 attention-only Transformer |
| 词表 | TinyStories 最常见的 3,000 个自然词 token |
| 训练序列 | 65,536 |
| 序列长度 | 200 |
| 初始化 | zero initialization |
| 优化器 | SGD |
| 学习率 | 0.005 |
| 有效 batch size | 2,048 |
| 理论统计样本 | 2,048 |
| 训练 | 10 epochs |
为了不改变有效 batch,我们使用 micro-batch 256 和八步梯度累积;理论矩阵的密集 one-hot 乘法则改写成数值等价的稀疏计数。完整配置和代码见 MergeOpt 仓库。
5.1 闭式方向真的出现在权重里
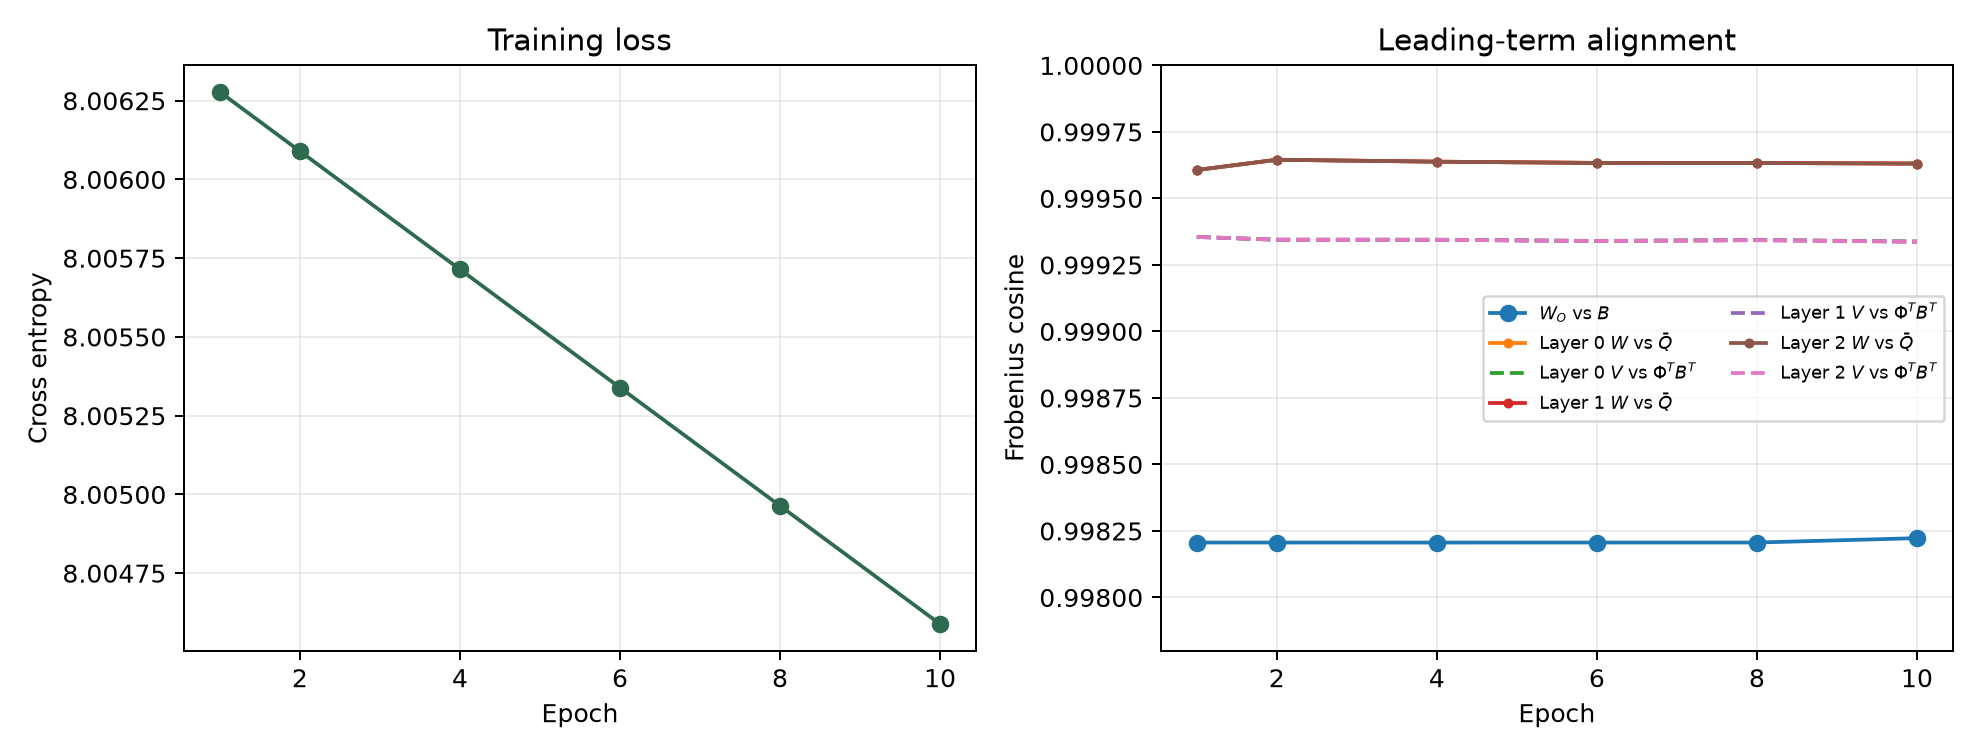
到 epoch 10:
| 对齐对象 | Frobenius cosine |
|---|---|
| vs. | 0.998223 |
| vs. | 0.999337 |
| QK matrix vs. | 0.999631 |
而且三层的曲线几乎重合。这与理论完全一致:零初始化附近,各层先从同一套 corpus-level associative basis 出发,层间分工要等更高阶项累积后才出现。
但请暂时不要把 cosine 接近 1 读成“机制已经强烈工作”。稍后我们会看到,方向和行为是两回事。
5.2 同一个 token,存在三种完全不同的“相关”
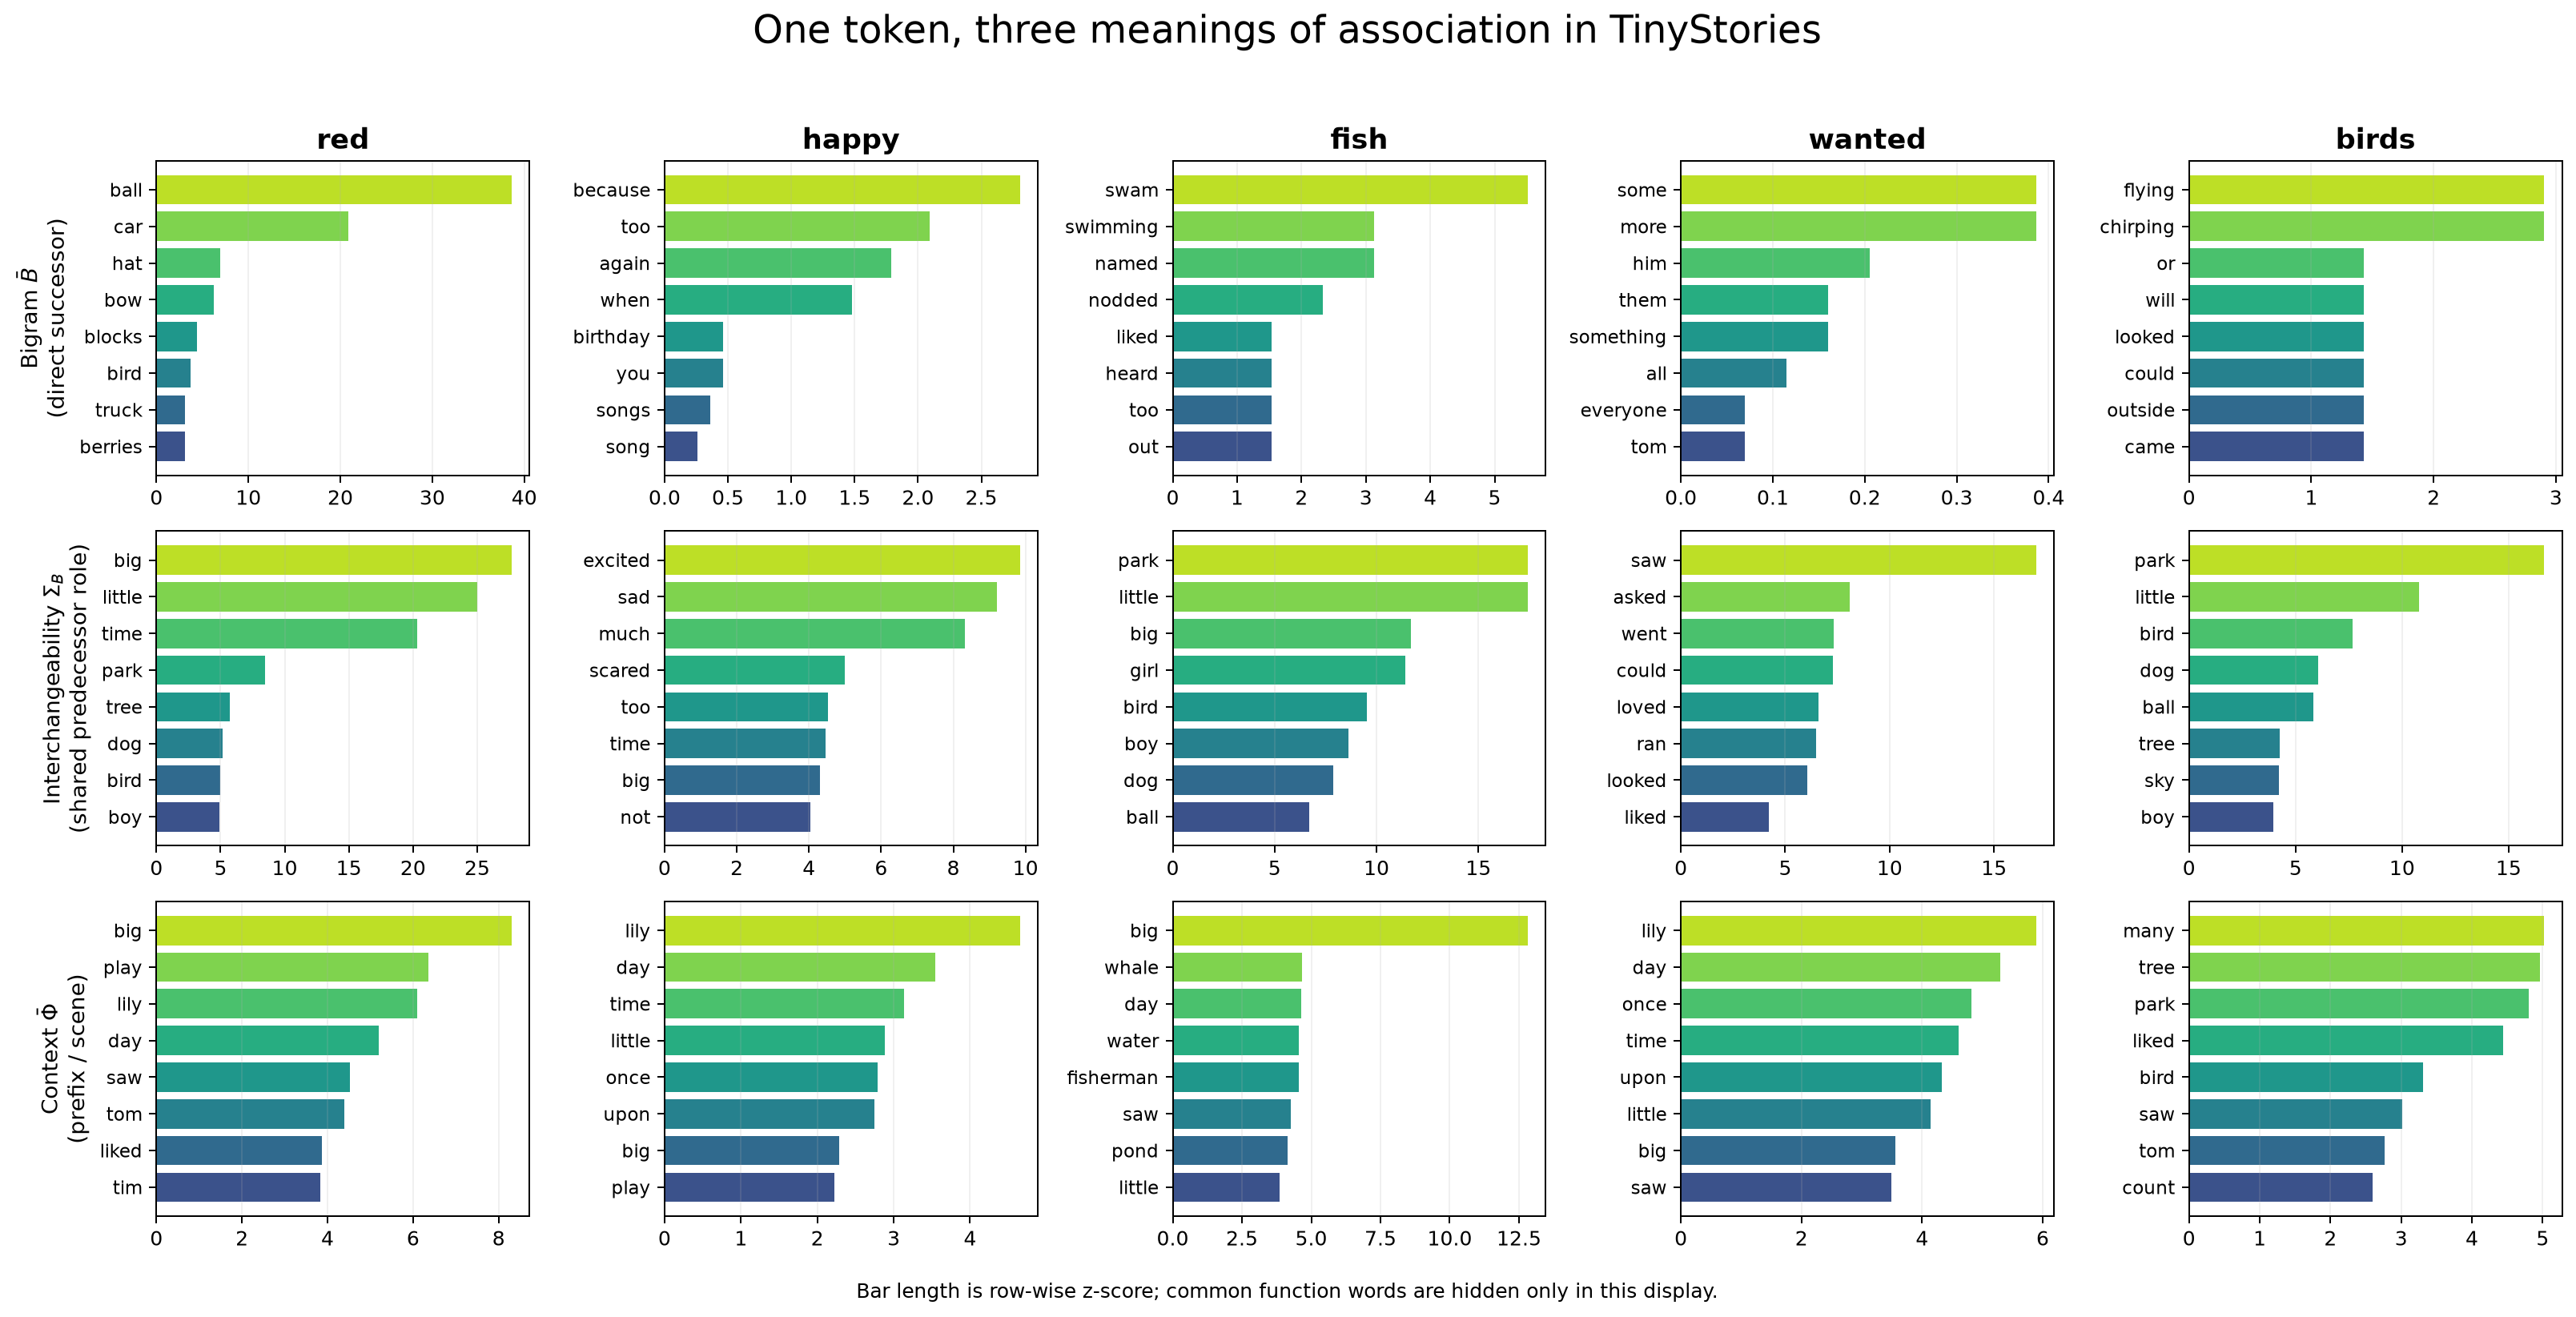
上图每一列是一个 anchor token,三行分别是 bigram、interchangeability 和 context 的邻居。
以 fish 为例:
Bigram:             swam / swimming / named
Interchangeability: park / little / big / girl / bird
Context:            whale / water / fisherman / pond
它很好地提醒我们,不要把所有共现都叫“语义相似”:
fish → swam是组合搭配;fish ↔ bird/girl更多是模板和语法角色上的可替换;fish ← pond/water才接近我们直觉中的场景知识。
在一个人工小型 category probe 上, 的同类 Top-10 命中率对 emotions 达到 42.2%,对 motion 为 17.8%,对 animals 为 16.4%;colors 却是 0%。原因并不神秘:情绪词高度共享 was ___ 模板,而颜色常和 big/little 共享形容词槽位。
模型学到的是数据中的功能几何,不是人类预先划好的本体论。
5.3 一条真实故事里的 context 是怎样被激活的
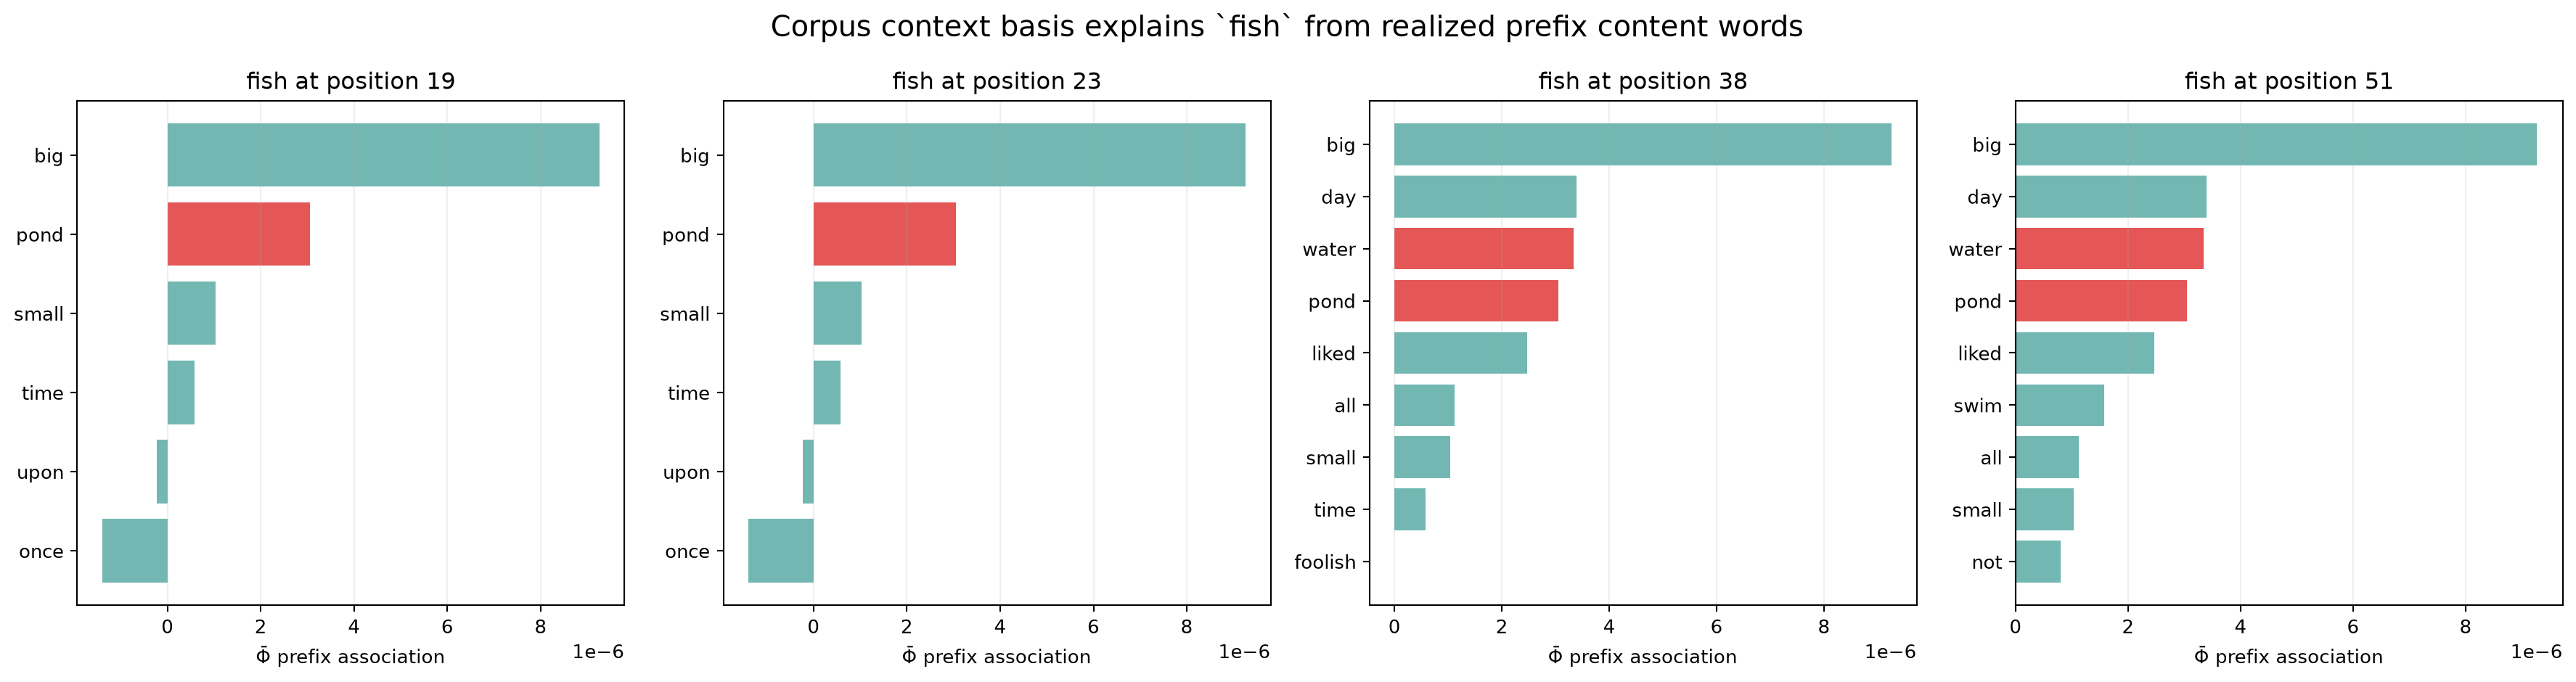
我们选取了 TinyStories 中的一条真实故事:
once upon a time, there was a small pond. in the pond, there was a big fish …
对故事中第 19、23、38、51 位置的 fish,只从它此前真实出现的内容词里寻找 证据。
早期的 fish 已经能从 pond 获得语料级支持;当 water 在后文出现,它也进入后续 fish 的解释集合。这里发生的是:
这正是从语料统计到条件化行为的最小原型。
5.4 Output 最先学到的是语言骨架
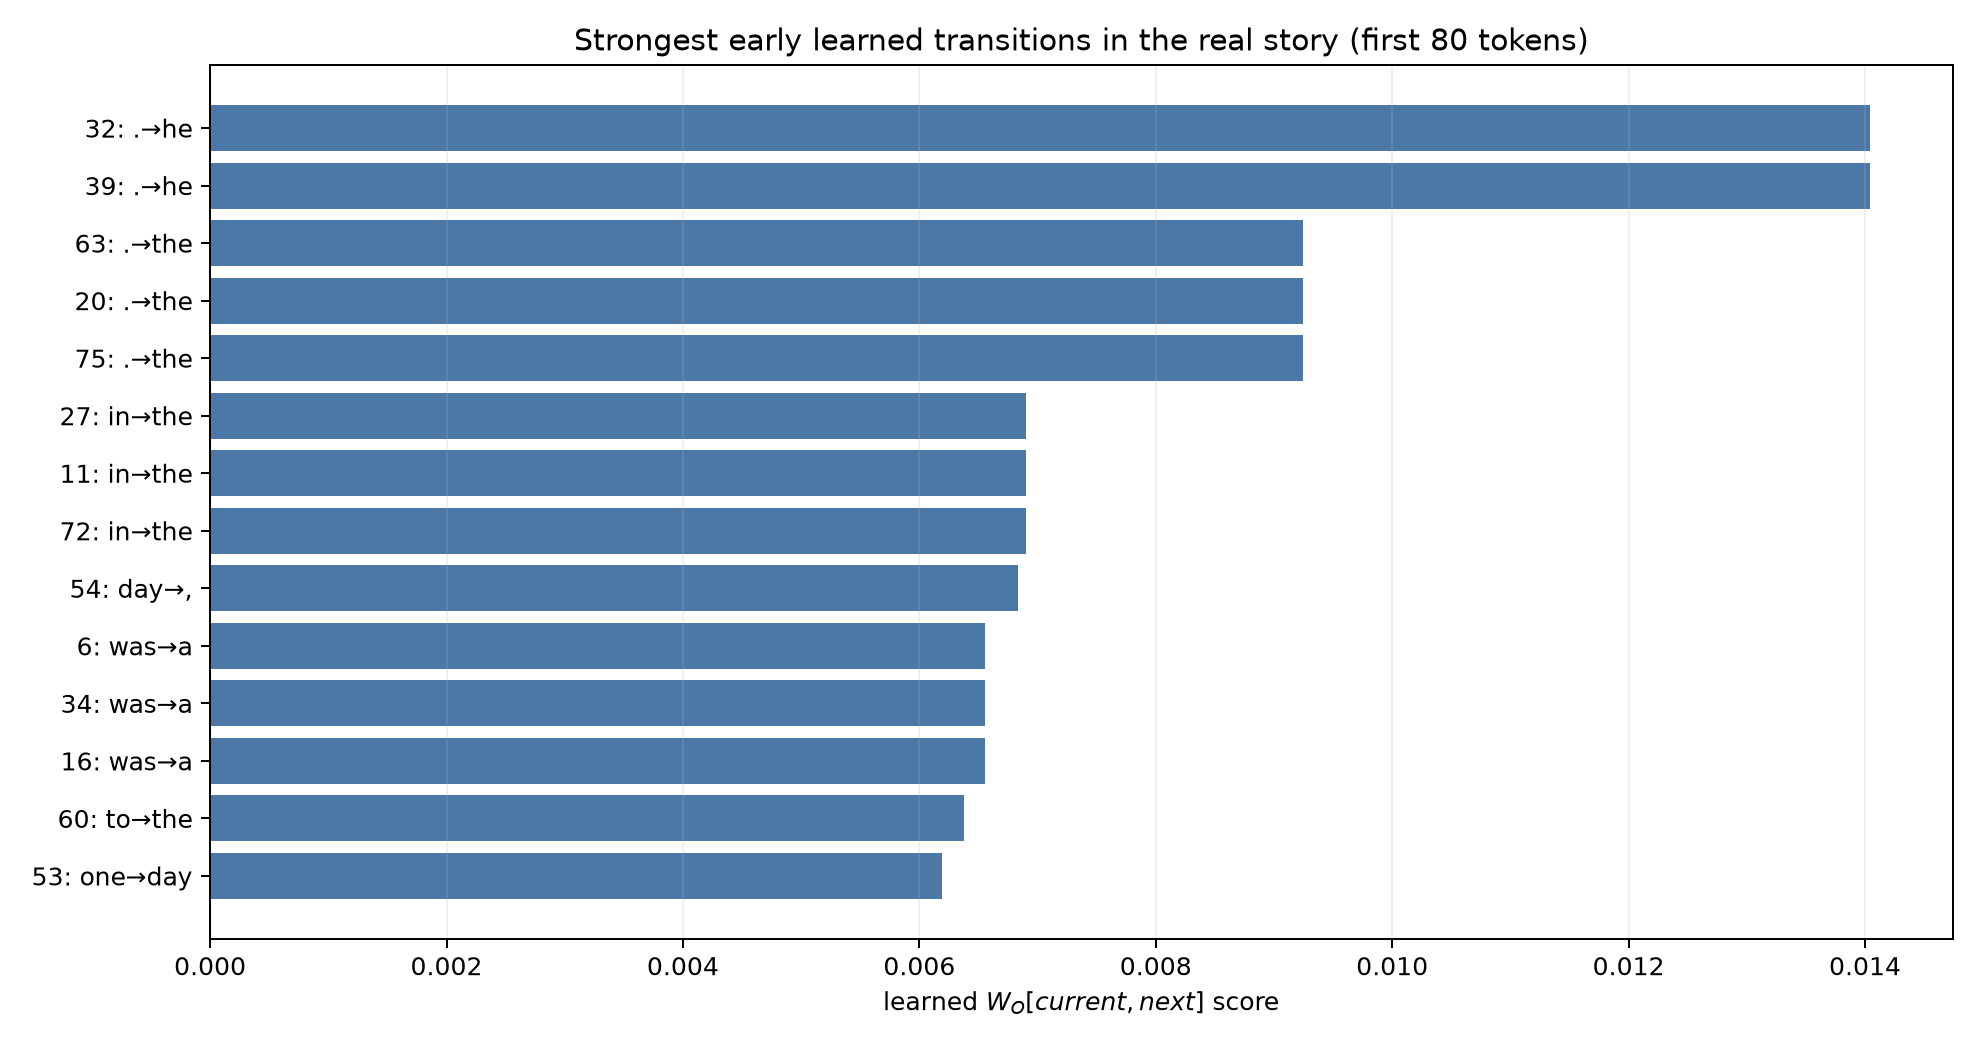
故事前 80 个 token 中,learned 最强支持的真实转移包括:
.   → he
.   → the
in  → the
day → ,
was → a
one → day
这些不是复杂的故事理解,而是介词、冠词、标点和 TinyStories 固定开场构成的语言骨架。
例如 . → he:
绝对值不必相同,因为闭式解还带有步数与学习率系数;重要的是矩阵方向与相对结构高度一致。
6. 最奇妙的结果:参数已经“懂了”,行为却还没开始
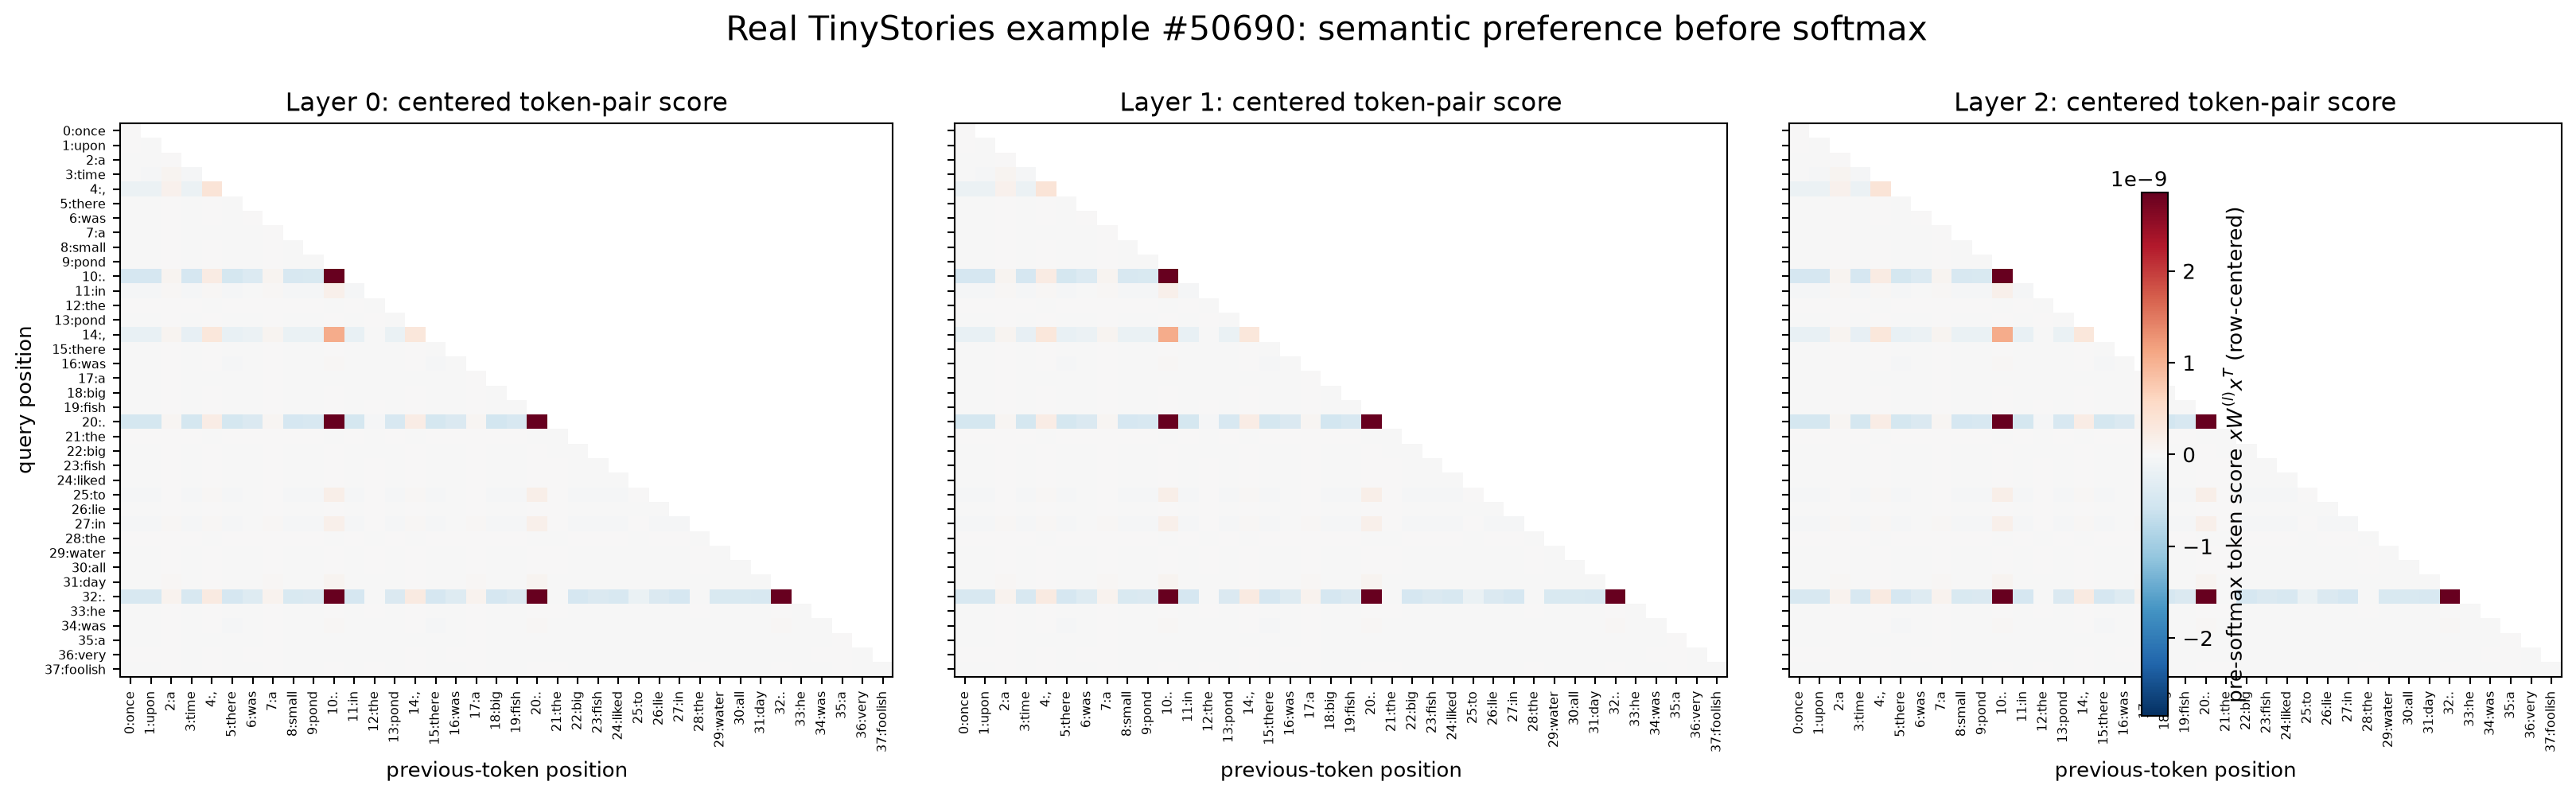
上图是三个 layer 在真实故事上的 pre-softmax、逐行中心化 token-pair score:
它们具有稳定结构,而且三层几乎一样。但 score 的尺度只有约 。在 float32 下:
实际 attention probability 相对均匀 causal attention 的最大可见变化是 0。
也就是说:
为了做因果检查,我们没有粗暴清零整层,而是只删除 learned weight 在理论 leading term 上的投影:
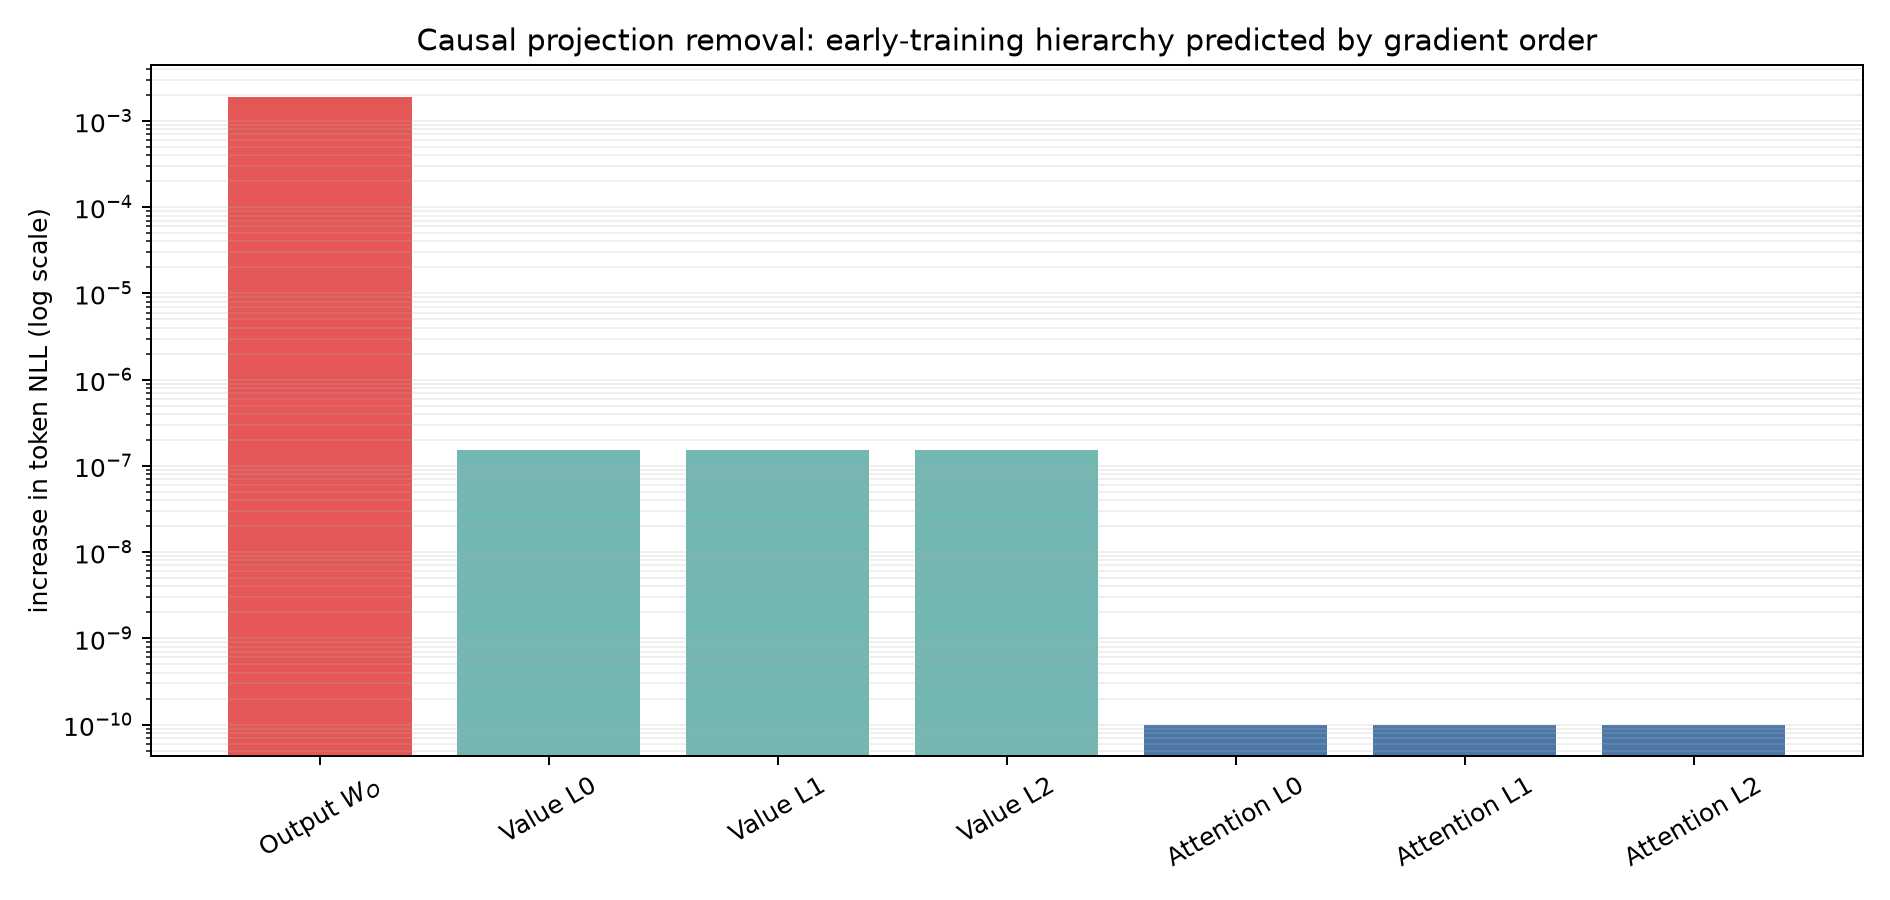
在 64 条样本上的结果:
| 删除对象 | token NLL |
|---|---|
| Output | |
| 每层 Value leading term | |
| 每层 Attention | 当前精度下为 0 |
这恰好复现了梯度阶数预测的行为层级:
论文在更大学习率、训练更充分的模型上做了同类消融:原 loss 为 5.349,删除 output leading term 后升到 8.287,删除 value 后约为 6.19—6.53,而删除三层 attention leading term 后只升到 5.350—5.361。论文附录呈现了同样的顺序,只是后期 value 已经真正生效。
这是机制可解释性中非常重要的警告:
参数方向可解释,不等于该方向已经具有可测的因果作用。
Probe、cosine similarity 和漂亮热力图只能告诉我们“结构在那里”;干预和行为评测才告诉我们“模型正在使用它”。
7. 一个不那么漂亮、但更真实的现象:组合也会放大模板偏置
论文里 QK 的核心 feature composition 是:
它先把 token 映射到功能相近的一类 token,再汇总这类 token 共享的长程上下文。我们把 fish 的路径拆开:
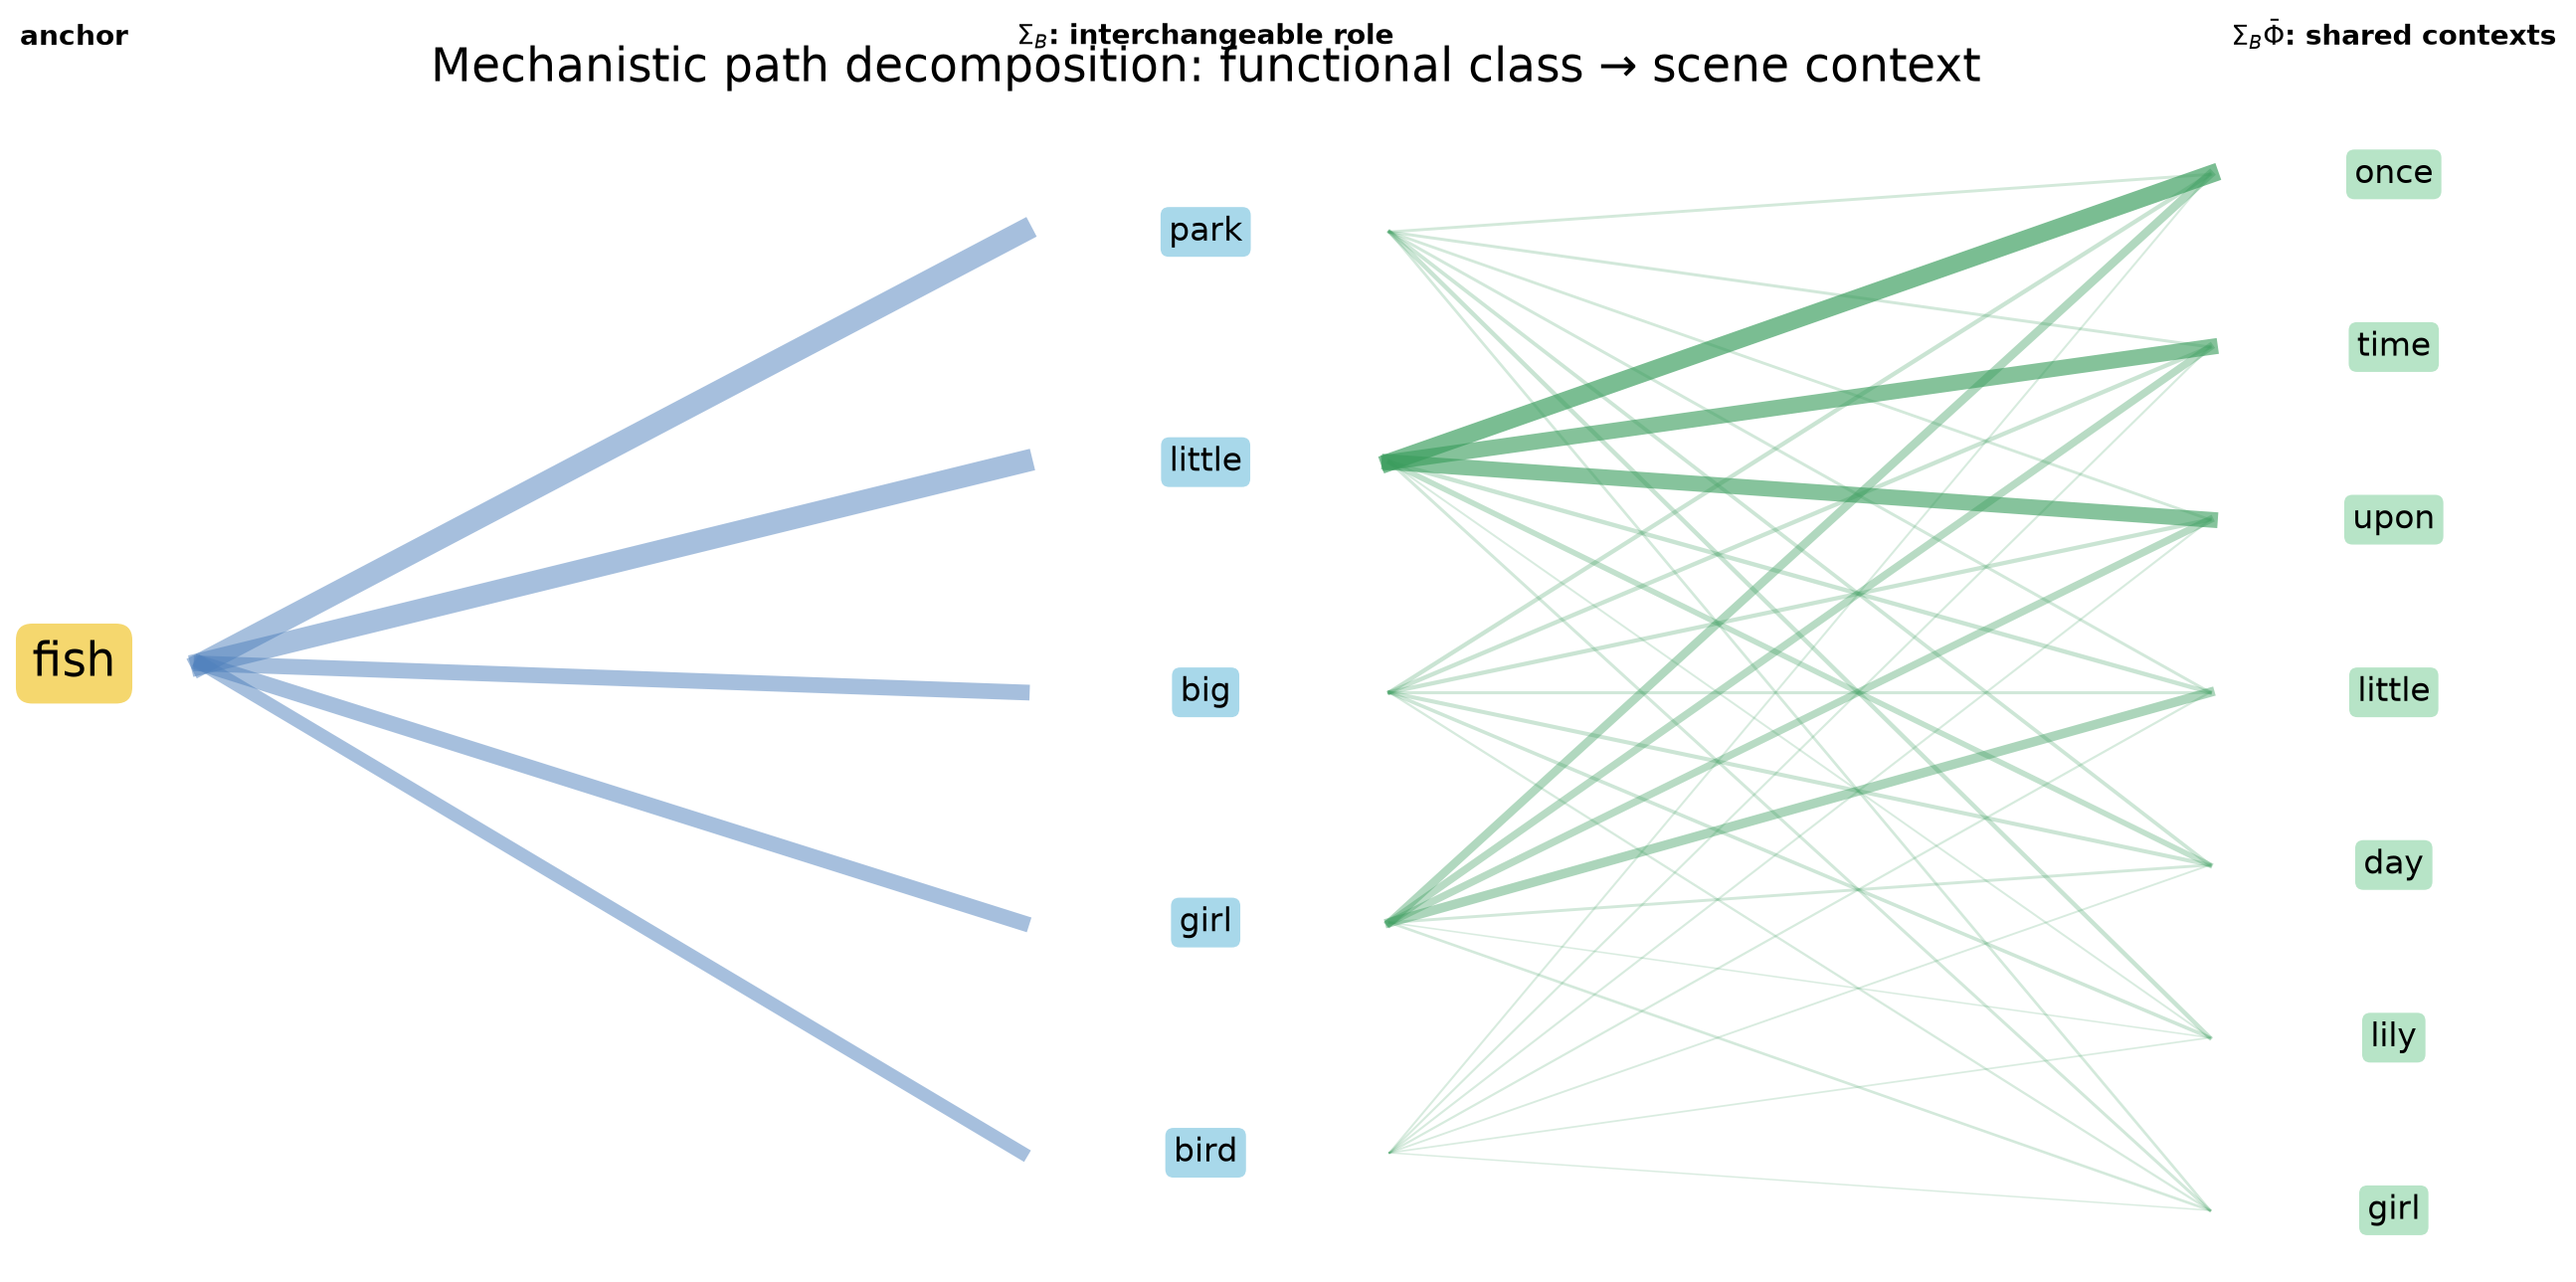
中间层最强的“可替换角色”不是纯动物类别,而是:
park / little / big / girl / bird继续经过 context mapping 后,最强共享上下文变成:
once / time / upon / little / day / lily / girl这显然没有 fish ↔ pond/water 那么符合人类对语义的期待,却非常符合 TinyStories 的模板:
once upon a time ...
one day ...
a little girl ...
这不是理论失败,反而是理论解释力最诚实的地方。矩阵组合传播的不是“真理”,而是训练语料中的统计结构;它会传播语义,也会传播模板、词频和偏置。
所谓 emergence 并不保证产生我们喜欢的抽象。它只保证局部统计经过可复用的计算结构后,能够形成新的、条件化的功能。
8. 从共同起点到层间分工:后期 drift 意味着什么
在我们的低学习率、10 epoch 复现中,三个 layer 几乎完全相同。这不是“每层都学会了同样强的语义”,而是它们尚处于共同 leading term 主导的阶段。
论文进一步在带 MLP、多头 attention 的 Pythia-1.4B 不同训练 checkpoint 上做分析。他们把各层的 token representation、平均 QK mapping 转到 token basis,再与 OpenWebText/FineWeb 统计得到的 leading-term covariance 比较。结果显示:早期 checkpoint 与理论 associative features 高度一致,随后不同层逐步 drift,且 attention head 开始以不同速度专门化;中间层的 head variance 尤其早地增大。Pythia 之所以适合这种研究,正是因为它公开了密集训练 checkpoint。[4]
我们可以把它理解成:
但这里必须保持克制。drift 本身只能证明模型离开了固定的 early associative basis;它与更丰富知识和高级能力的形成一致,却不能单独证明某项推理能力由 drift 导致。
更准确的说法是:
Leading-term 理论解释了高级能力长出来之前的共同地基;drift 标记了这个简单解释开始失效、模型开始专门化的地方。
这并不是理论的尴尬边界,而是下一阶段机制研究最自然的起点:后来的 component 在保留多少统计地基的同时,又增加了哪些可组合结构?
9. 这个 toy model 真正教会我们的 Transformer 直觉
现在可以把整个故事压缩成三句话。
9.1 :先学会平均世界
当前 token 直接查表,给出平均 next-token 分布。这是局部统计能力,也是最早可见的语言骨架。
9.2 :让过去能够改变现在
历史 token 不再只是一个 token ID。它被映射成一组可由输出层读取的预测修正,把长程 context 与功能可替换性带进当前 logits。
9.3 QK:只在需要时取用正确的过去
当前 query 根据自己的 next-token 需求,为历史 token 的 message 定价。Key 不是静态标签;它只有相对于某个 query 的需求才有意义。
因此,attention 不是“把所有信息混合一下”,也不只是“找相似 token”。它做的是:
这也解释了为什么仅有 bigram 统计仍是记忆,而 QK 的组合开始具有泛化味道:相同的历史证据可以服务多个功能相近的候选,相同的 query 需求也可以在不同故事中从不同位置获得满足。
Transformer 的奇妙之处,不是 Q/K/V 的命名有多聪明,而是 next-token loss 通过梯度下降,自发地把一个统计查表器扩展成了信息搬运器,再扩展成按需路由器。
10. 最后仍要记住它解释不了什么
这篇论文和我们的复现解释的是能力形成的初期地基,不是完整 LLM 的心智模型:
- toy model 在词表 one-hot 空间中工作,没有标准 learned embedding;
- 没有 MLP 和 LayerNorm,且直接参数化组合后的 QK matrix;
- 理论主要约束零初始化或足够小的 Gaussian 初始化、足够早的训练窗口;
- 早期 attention 的实际行为极弱,本文解释的是方向如何萌芽;
- Pythia 实验比较的是 token-correlation covariance,属于对理论向真实 LLM 外推的支持,而不是完整等价证明。
但正因为边界清楚,这个 toy model 才是一个极好的 Transformer 入门案例。它没有用拟人化比喻替代数学,而是让我们看见:一个功能如何从语料统计、计算图和梯度阶数中一步一步长出来。
如果以后再有人告诉你“Query 是问题,Key 是目录,Value 是答案”,可以继续追问一句:
为什么训练会让它们变成这样?
至少在 Transformer 学会关联 token 的最初阶段,我们现在有了一个相当具体的答案。
参考资料
- Shawn Im, Changdae Oh, Zhen Fang, Sharon Li. How Do Transformers Learn to Associate Tokens: Gradient Leading Terms Bring Mechanistic Interpretability, ICLR 2026.
- 作者开源代码:deeplearning-wisc/attn-dynamics-basis.
- Ronen Eldan, Yuanzhi Li. TinyStories: How Small Can Language Models Be and Still Speak Coherent English?, 2023.
- Stella Biderman et al. Pythia: A Suite for Analyzing Large Language Models Across Training and Scaling, ICML 2023.
- Ashish Vaswani et al. Attention Is All You Need, NeurIPS 2017.
- Catherine Olsson et al. In-context Learning and Induction Heads, 2022.